Memahami Token pada LLM
Photo by Egor Komarov on Unsplash
Kita sering mendengar istilah token akhir-akhir ini ketika menggunakan AI dalam keseharian. Tapi mungkin sebagian dari kita belum benar-benar tahu apa yang dimaksud dengan token. Untuk apa token digunakan ketika AI memproses prompt yang kita berikan? Dan di balik proses AI yang terasa magic, bagaimana token dihitung sampai kita sering mendapatkan peringatan kalau penggunaan sudah melewati batas?
Pertanyaan-pertanyaan inilah yang membuat artikel ini ada. Mari kita bahas satu per satu, dengan harapan bisa membuka pengetahuan baru dan meningkatkan awareness kita dalam menggunakan AI.
Apa itu token?
Token adalah potongan teks yang dipakai model (LLM) sebagai unit pemrosesan. Token dapat mewakili sebuah karakter, bagian dari kata, sebuah kata utuh, bagian kode, atau tanda baca. Bahkan spasi juga dapat memengaruhi bagaimana token dibentuk.
Dari penjelasan di atas kita bisa menarik kesimpulan kalau token tidak selalu sama dengan satu kata, artinya jumlah token tidak sama dengan jumlah kata. Teks yang sama persis pun dapat menghasilkan token yang berbeda, tergantung tokenizer yang dipakai oleh model tersebut.
Tokenizer, Vocabulary, dan Token ID
Pada tahap ini kita akan membahas apa yang terjadi ketika prompt kita dikirim ke model AI. Tahap pertama, prompt yang kita tulis dalam kata-kata yang mudah dipahami manusia akan diproses menjadi token menggunakan tokenizer. Tokenizer adalah komponen yang bertugas memecah teks menjadi token agar bisa diproses oleh LLM.
Bagaimana cara kerjanya? Untuk mencobanya kita bisa menggunakan tokenizer yang disediakan Hugging Face: The Tokenizer Playground. Pada percobaan ini saya memilih tokenizer GPT-4, dan hasilnya seperti ini:
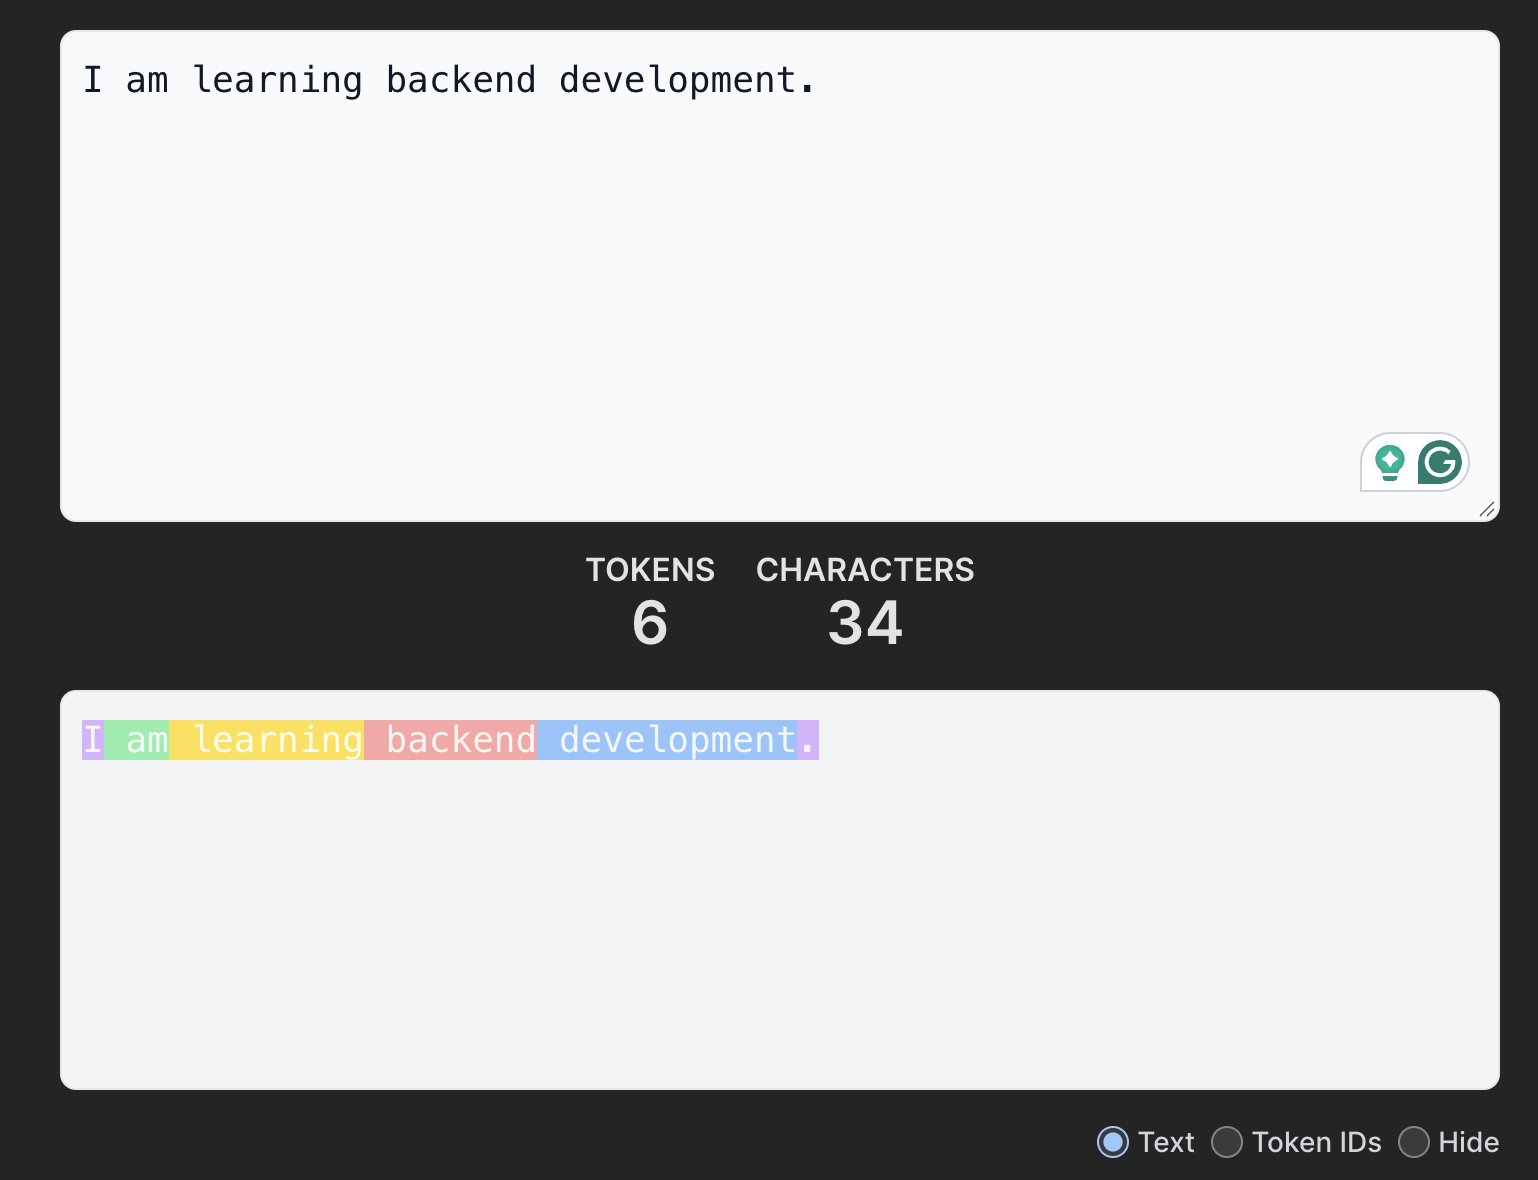
Pada gambar di atas kita bisa melihat teks dipecah menjadi beberapa bagian. Setelah dipecah, setiap token akan memiliki angka identitasnya sendiri-sendiri. Identitas ini disebut Token ID.
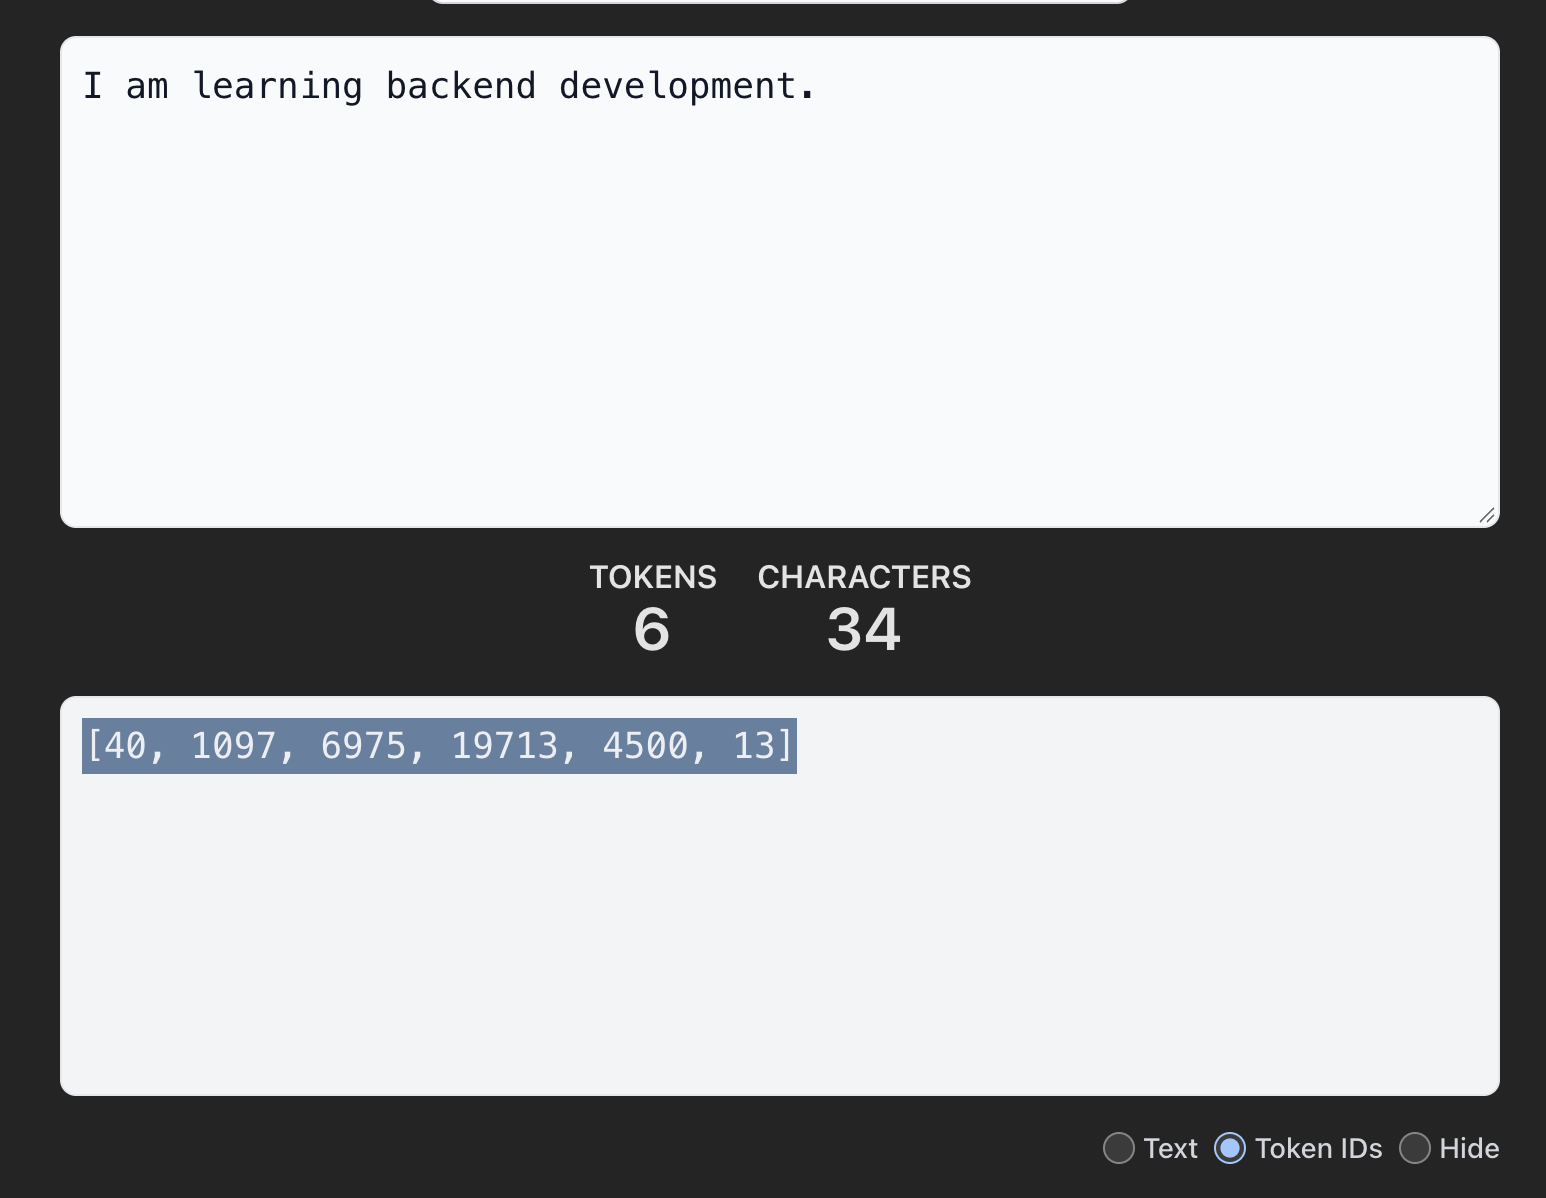
Bisa kamu lihat pada gambar di atas, token sudah dikonversi menjadi Token ID oleh tokenizer. Hasilnya seperti ini:
| Token | Token ID |
|---|---|
I | 40 |
␣am | 1097 |
␣learning | 6975 |
␣backend | 19713 |
␣development | 4500 |
. | 13 |
Perhatikan tanda ␣ di depan beberapa token. Itu menandakan spasi ikut menjadi bagian dari token, jadi ␣am dan am adalah dua token yang berbeda.
Mungkin muncul pertanyaan, dari mana Token ID ini berasal dan bagaimana tokenizer bisa menentukan kalau token x memiliki Token ID y? Jawabannya adalah vocabulary, yaitu kumpulan token yang dikenal oleh tokenizer beserta nomor ID-nya. Vocabulary ini dibangun dari data latih: potongan teks yang sering muncul akan dijadikan satu token utuh, sedangkan kata yang jarang muncul akan dipecah menjadi beberapa potongan yang lebih kecil.
Perlu diingat, setiap tokenizer memiliki vocabulary dan aturan pemecahan teks yang bisa berbeda, bahkan antar generasi model dari provider yang sama. Artinya walaupun teks yang dikirim sama, token dan Token ID yang dihasilkan belum tentu sama.
Analogi sederhananya agar kita lebih mudah memahami 3 komponen ini kurang lebih seperti ini: bayangkan ada sebuah katalog berisi potongan-potongan teks, dan setiap potongan sudah punya nomor identitasnya. Katalog ini adalah vocabulary. Tokenizer bertugas memotong teks kita, lalu mencocokkan setiap potongan dengan isi katalog untuk mendapatkan nomornya, yaitu Token ID.
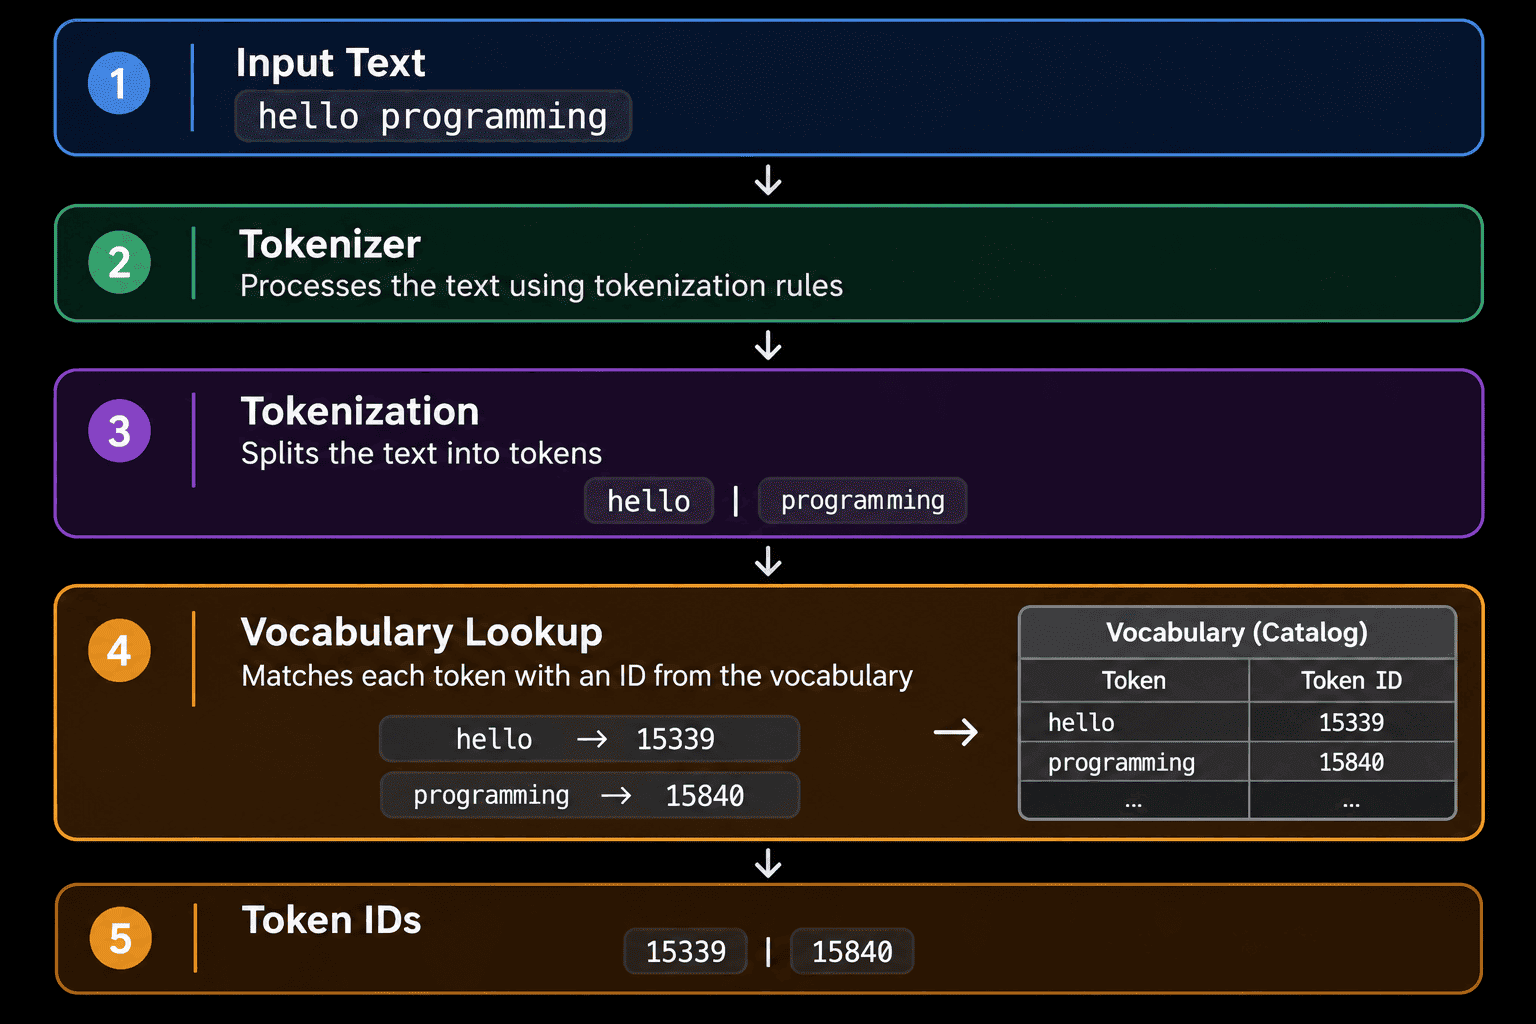
Ini adalah gambaran penyederhanaan konseptual, bukan urutan internal yang wajib digunakan semua tokenizer.
Cukup jelas ya?
Mengapa jumlah kata, karakter, dan token berbeda?
Sekarang kita coba eksperimen lagi, kali ini menggunakan tokenizer yang disediakan oleh OpenAI: OpenAI Platform Tokenizer dengan pilihan tokenizer GPT-5.x. Kita akan memberikan input kalimat yang sama dalam bahasa Inggris dan bahasa Indonesia, ditambah potongan kode Go. Tujuannya untuk melihat jumlah karakter dan berapa token yang dihasilkan. Mari kita mulai.
- Percobaan A — Bahasa Inggris
I am a backend engineer.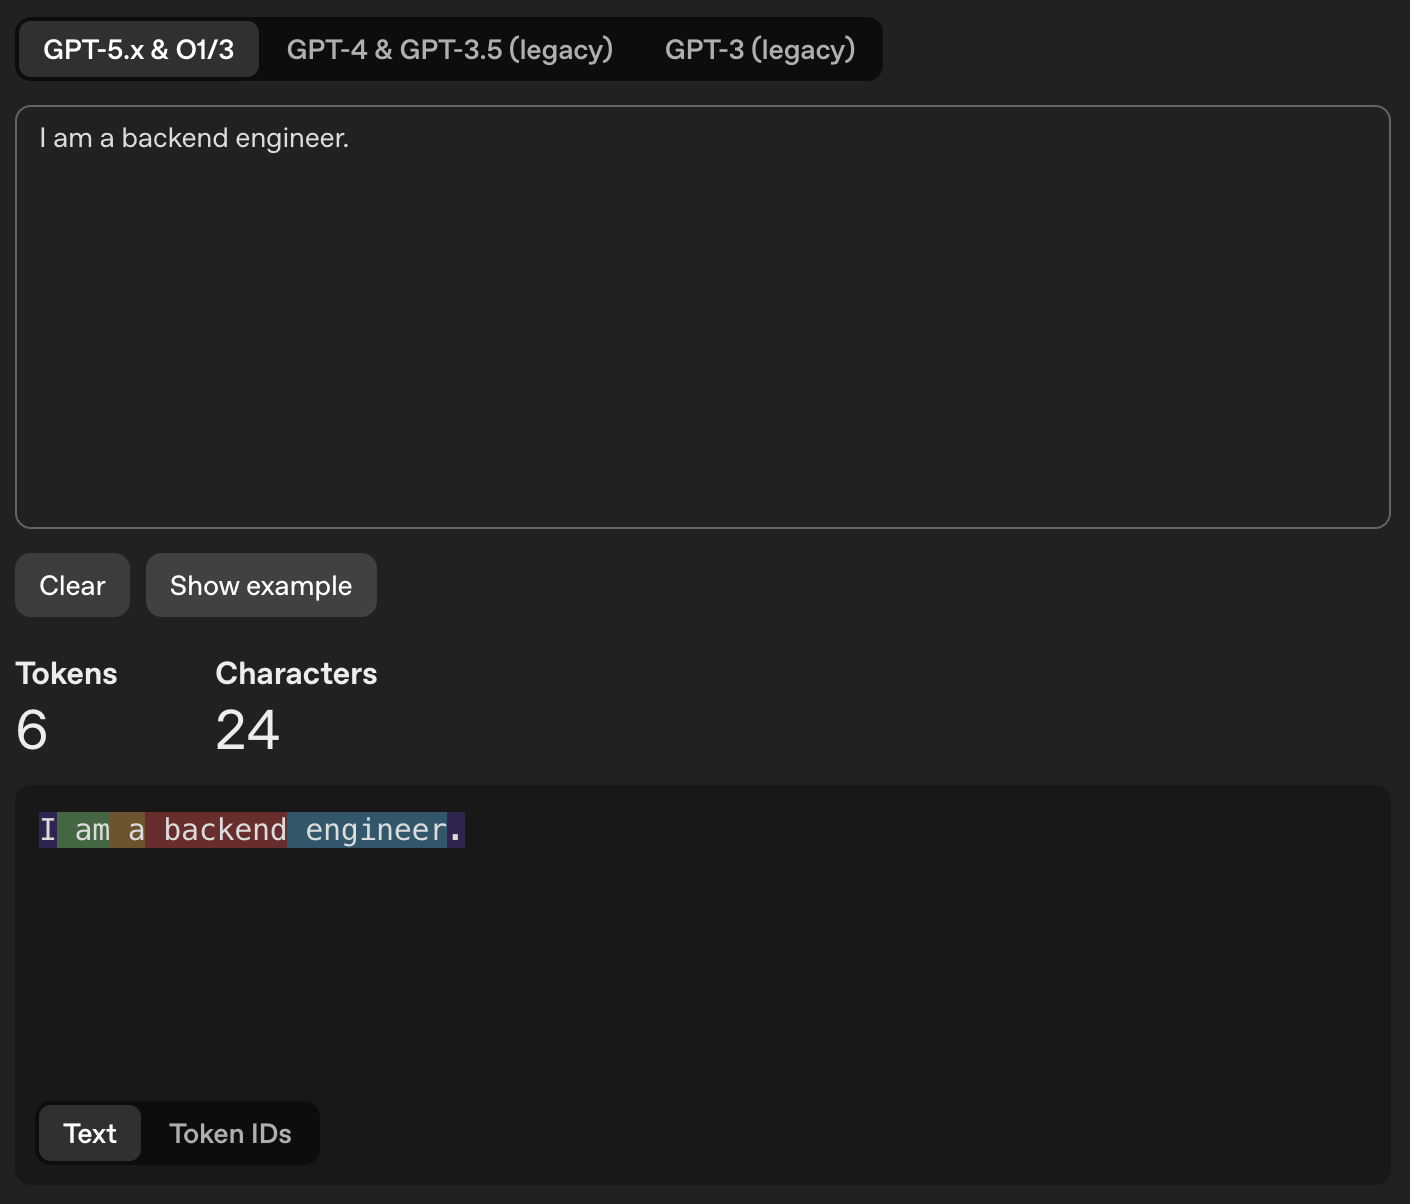
- Percobaan B — Bahasa Indonesia
Saya adalah seorang backend engineer.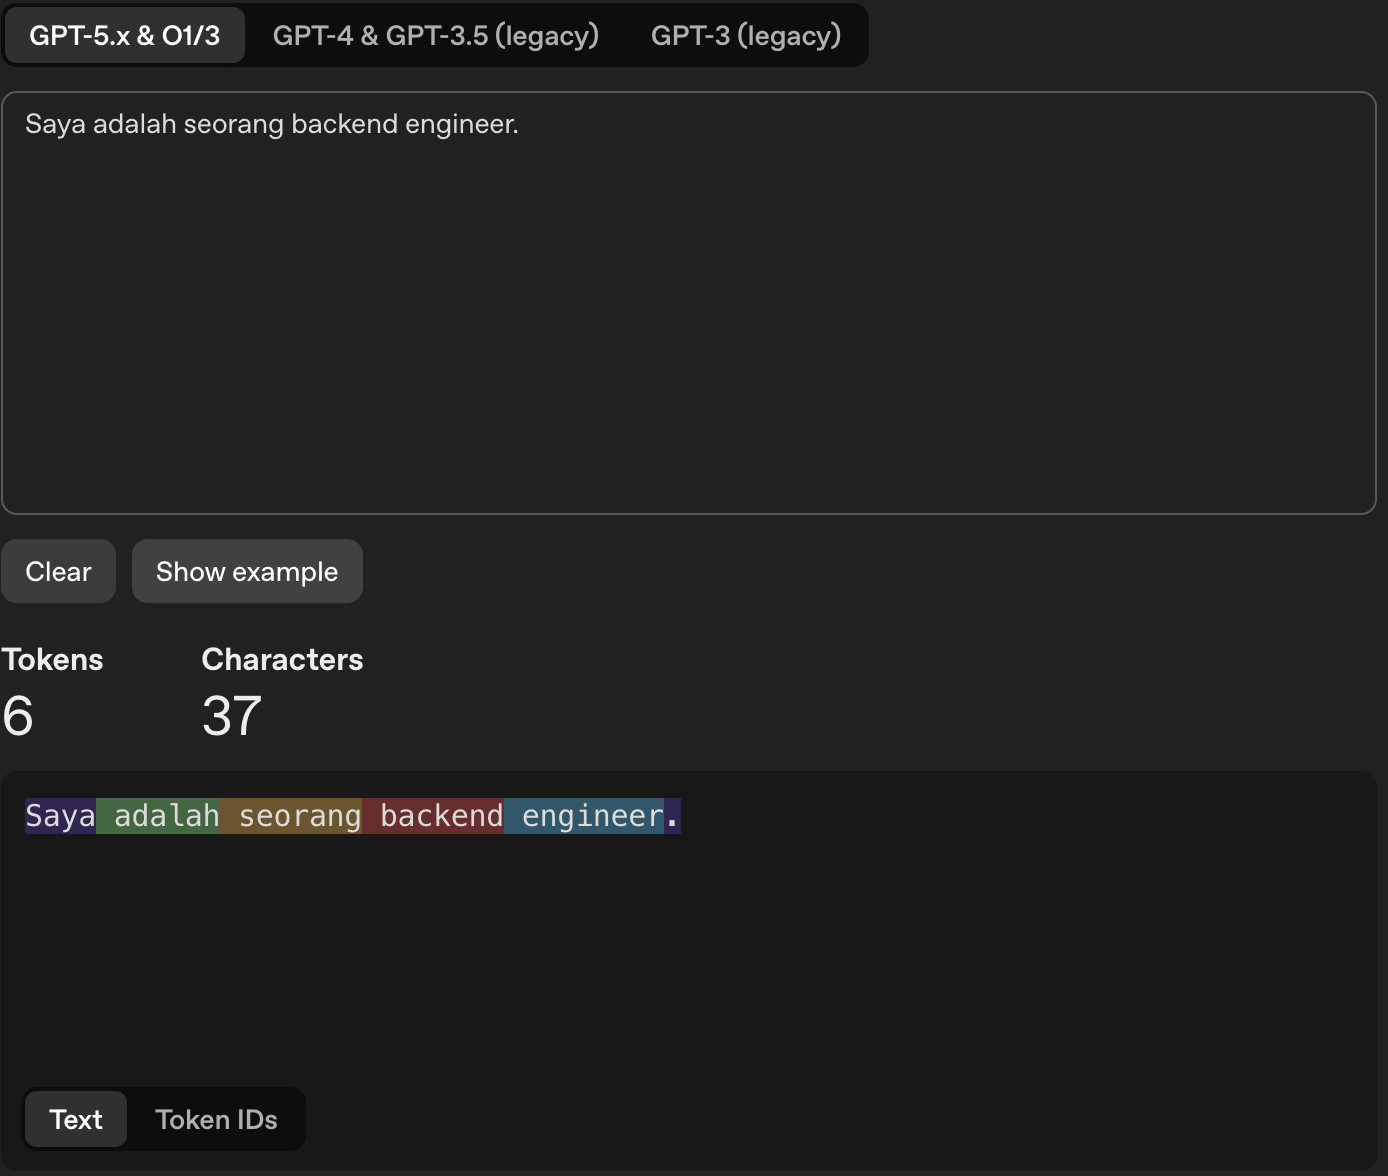
- Percobaan C — Kode Go
func main() {
    fmt.Println("Hello World")
}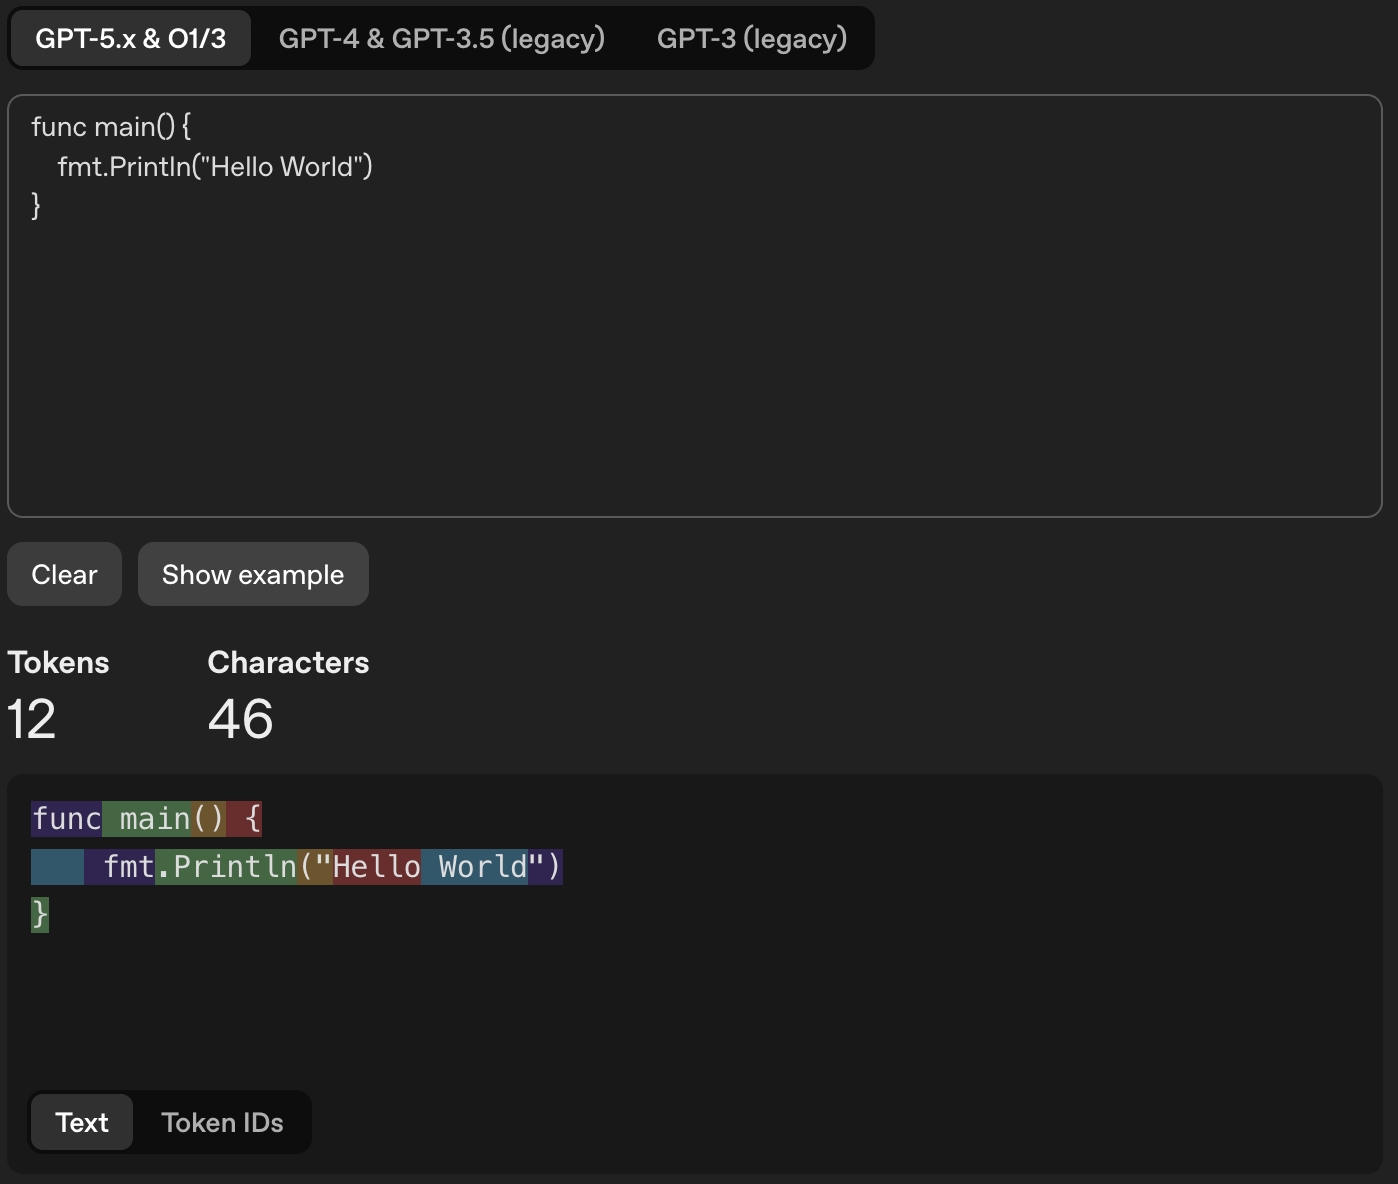
Yang perlu kita amati dari hasil tokenizer di atas adalah:
- Berapa jumlah token yang dihasilkan?
- Bagaimana tokenizer membagi teks tersebut?
- Apakah jumlah token sesuai dengan jumlah kata atau baris kode?
Berikut hasil eksperimen yang kita catat.
| Teks | Panjang Karakter | Token |
|---|---|---|
I am a backend engineer. | 24 | 6 |
Saya adalah seorang backend engineer. | 37 | 6 |
| Kode Go (Percobaan C) | 46 | 12 |
Angka ini berlaku untuk tokenizer yang dipilih saat eksperimen, bukan aturan yang sama untuk semua model atau provider.
Nah, mari kita jawab ketiga pertanyaan tadi:
- Jumlah token — kalimat bahasa Inggris dan Indonesia sama-sama menghasilkan 6 token, sedangkan 3 baris kode Go menghasilkan 12 token.
- Cara membagi — untuk kedua kalimat, setiap kata menjadi satu token (spasi di depannya ikut menempel), ditambah satu token untuk tanda titik. Pada kode Go pembagiannya lebih rapat: tanda baca bisa menjadi token sendiri atau bergabung dengan karakter di sebelahnya (misalnya
.Printlndan("), bahkan indentasi di awal baris kedua menjadi satu token tersendiri. - Token vs kata/baris — tidak ada hubungan yang pasti. Kalimat Indonesia 13 karakter lebih panjang tapi jumlah tokennya sama, dan 3 baris kode menjadi 12 token.
Dari sini kita bisa ambil pelajaran: teks yang lebih panjang tidak otomatis menghasilkan lebih banyak token. Yang menentukan adalah apakah potongan teks tersebut sudah ada di vocabulary. Kata adalah dan seorang cukup sering muncul di data latih sehingga tokenizer GPT-5.x yang vocabulary-nya besar menyimpannya sebagai satu token utuh. Di tokenizer lama dengan vocabulary yang lebih kecil, kata-kata non-Inggris lebih sering dipecah menjadi beberapa token. Kamu bisa mencobanya sendiri dengan berpindah ke tab GPT-3 (legacy) di halaman tokenizer OpenAI.
Tapi ingat, hasil eksperimen ini tidak berlaku universal ya. Secara umum, teks bahasa Inggris masih yang paling efisien. OpenAI memberi patokan kasar[1] 1 token ≈ 4 karakter atau sekitar ¾ kata untuk teks bahasa Inggris, dan teks non-Inggris sering kali memiliki rasio token per karakter yang lebih tinggi. Faktor seperti bahasa, tanda baca, struktur kode, dan tokenizer tetap harus ikut diperhitungkan.
Input tokens dan output tokens
Ketika kita mengirim prompt ke LLM, ada biaya input dan output yang dihitung. Sebagai Backend Engineer yang biasa mengurus API, langsung terbersit pertanyaan di kepala saya: “Kenapa output juga dihitung sebagai biaya ya? Bukannya output itu hasil proses di backend yang sudah jadi, tinggal lempar response saja?” Oke, mari kita bahas satu per satu hal yang saya pahami setelah mempelajarinya.
Input tokens adalah token yang dikirim ke model. Isinya bukan hanya teks perintah yang kita kirim, tapi juga mencakup system prompt, instruksi pengguna, riwayat percakapan, source code atau dokumen, definisi tool yang tersedia, serta hasil tool yang dimasukkan kembali ke dalam konteks.
Output tokens adalah token yang dihasilkan model sebagai respons, misalnya jawaban, penjelasan, kode yang dibuat, atau permintaan untuk menjalankan tool.
Kurang lebih alur sederhananya bisa kita lihat pada diagram ini.
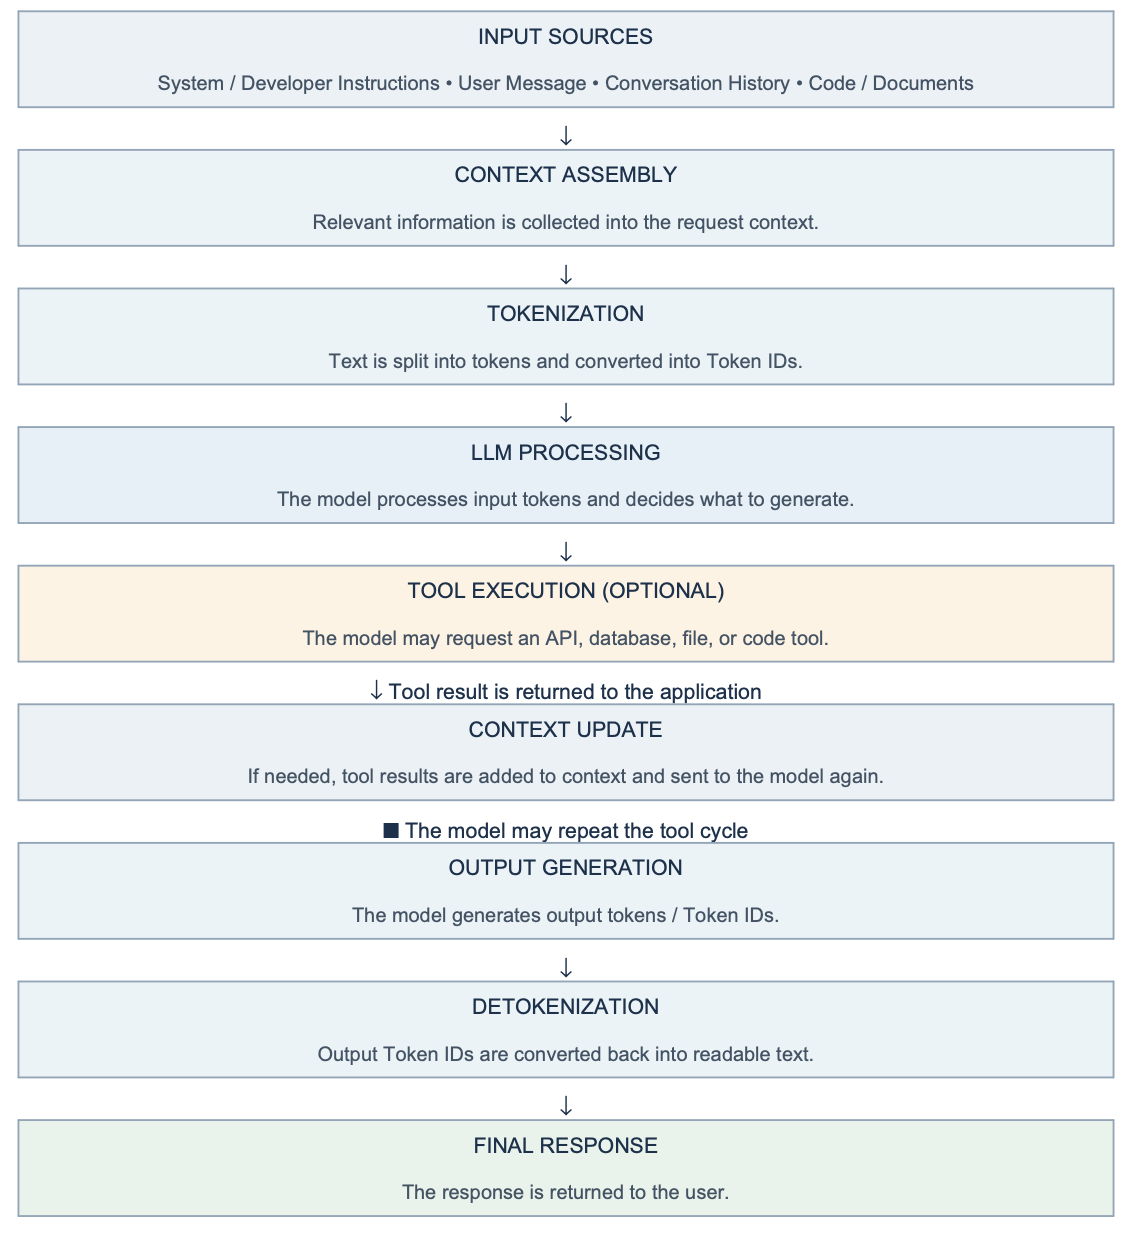
Mari kita baca diagram di atas:
- Input Sources — Model bisa menerima aturan aplikasi, teks perintah yang kita kirim, riwayat percakapan yang masih relevan, serta kode atau dokumen. Jadi input model tidak selalu hanya pesan perintah terakhir.
- Context Assembly — Aplikasi mengumpulkan informasi yang dibutuhkan dan menyusunnya menjadi konteks. Di bagian ini tidak semua riwayat harus dikirim, bisa dipilih bagian yang relevan saja.
- Tokenization — Teks dipecah menjadi token, lalu token direpresentasikan sebagai Token ID berupa angka yang diproses model.
- LLM Processing — Model memproses Token ID yang masuk dan menentukan langkah berikutnya, bisa langsung menjawab atau meminta aplikasi menjalankan tool.
- Tool Execution (Optional) — Tahap ini tidak wajib. Model tidak menjalankan tool sendiri; model hanya menghasilkan permintaan pemanggilan tool (dan permintaan ini juga dihitung sebagai output token), lalu aplikasi yang menjalankannya. Contohnya mengambil data dari database, memanggil API, membaca file, atau menjalankan kode.
- Context Update — Jika tool menghasilkan informasi atau data baru, aplikasi menambahkannya ke konteks dan mengirimkannya lagi ke model sebagai request baru. Proses ini bisa terjadi lebih dari sekali sampai informasinya cukup.
- Output Generation — Setelah informasinya cukup, model menghasilkan output berupa Token ID. Output dapat berupa jawaban atau instruksi lanjutan, tergantung proses yang sedang berjalan.
- Detokenization — Token ID yang dihasilkan diubah kembali menjadi teks yang bisa dibaca manusia.
- Final Response — Tahap terakhir, respons akhir dikirim kembali ke pengguna.
Jadi, kenapa output juga ada biayanya?
Jawabannya ada di tahap Output Generation. Output tidak “sudah jadi lalu tinggal dikirim” seperti response API pada umumnya. Model menghasilkan jawaban satu token demi satu token: setiap token baru ditentukan berdasarkan seluruh input ditambah token-token output yang sudah dihasilkan sebelumnya. Artinya, untuk setiap token output model harus melakukan satu kali komputasi penuh, dan token berikutnya baru bisa dibuat setelah token sebelumnya selesai.
Berbeda dengan input, seluruh token input sudah tersedia sejak awal sehingga bisa diproses sekaligus secara paralel. Karena itulah harga output per token biasanya jauh lebih mahal dibandingkan input.
Perlu diingat juga, pada model reasoning ada token “berpikir” yang dihasilkan sebelum jawaban akhir. Token ini tidak ditampilkan secara utuh ke kita (disembunyikan atau hanya diberikan ringkasannya), tapi tetap dihitung sebagai output token[2].
Dari penjelasan di atas kita juga mendapatkan pemahaman kalau LLM tidak selalu menerima pesan lalu langsung menjawab. Proses di dalamnya tentu lebih rumit dari diagram di atas, tapi setidaknya kita punya gambaran besar bagaimana instruksi yang kita kirim bisa menghasilkan jawaban.
Kenapa kita sering kena limit?
Sekarang kita bisa menjawab pertanyaan di awal artikel. Ada dua jenis batas yang sering kita temui:
- Context window — batas maksimal token dalam satu request, mencakup input dan output. Jika riwayat percakapan, dokumen, dan jawaban model melebihi batas ini, sebagian konteks harus dipangkas atau request akan ditolak.
- Usage limit / rate limit — batas jumlah token atau request dalam periode tertentu, misalnya per menit, per hari, atau per paket langganan. Peringatan “limit sudah habis” biasanya berasal dari batas jenis ini.
Lalu kenapa batas tersebut cepat tercapai? Kuncinya, LLM bersifat stateless: model tidak mengingat percakapan sebelumnya. Supaya model “ingat”, aplikasi harus mengirim ulang riwayat percakapan di setiap request. Semakin panjang percakapan, semakin banyak input token yang dikirim di setiap pesan baru.
Hal yang sama terjadi pada siklus tool di tahap 5 dan 6. Setiap kali hasil tool dikirim kembali ke model, itu adalah request baru yang membawa seluruh konteks sebelumnya ditambah hasil tool. Inilah alasan AI agent yang memanggil banyak tool bisa menghabiskan token jauh lebih cepat daripada tanya-jawab biasa.
Menghitung biaya API
Kita juga akan mencari tahu bagaimana simulasi menghitung biaya token. Dengan mengetahui jumlah token sebelum mengirim request, kita bisa memperkirakan biaya dan memastikan prompt kita masih muat di dalam context window. Biasanya setiap provider menyediakan library atau API untuk menghitung jumlah token, misalnya tiktoken[3] dari OpenAI. Setelah jumlah tokennya diketahui, biayanya bisa kita hitung dengan rumus umum berikut:
Biaya = (jumlah token ÷ 1.000.000) × harga per 1 juta tokenMari kita coba dengan harga simulasi berikut (bukan harga provider tertentu):
| Jenis | Token | Harga / 1 juta token | Total Biaya |
|---|---|---|---|
| Input | 4.000 | $1 | $0,004 |
| Output | 1.000 | $5 | $0,005 |
| Total | 5.000 | - | $0,009 |
Rinciannya sebagai berikut:
Input  = 4.000 ÷ 1.000.000 × $1 = $0,004
Output = 1.000 ÷ 1.000.000 × $5 = $0,005
Total  = $0,004 + $0,005 = $0,009
Perhatikan, walaupun jumlah output token hanya seperempat dari input, biayanya justru lebih besar. Ini sejalan dengan pembahasan sebelumnya bahwa output lebih mahal untuk dihasilkan.
Biaya di atas hanyalah contoh. Untuk biaya aktual, silakan lihat langsung halaman harga masing-masing provider.
Kesimpulan
Dengan memahami apa itu token, bagaimana tokenizer mengubah teks biasa menjadi token, kenapa output lebih mahal dari input, dan bagaimana biaya dihitung, kita jadi punya gambaran yang lebih utuh tentang apa yang terjadi di balik AI yang kita gunakan sehari-hari. Kita tidak hanya bertanya atau memberikan tugas lalu selesai, tapi juga bisa memperhitungkan dampak dari setiap perintah yang kita kirimkan, mulai dari panjang konteks sampai biaya yang dikeluarkan.
Pembahasan di atas adalah catatan pembelajaran saya pribadi. Kesalahan penjelasan dan pemahaman bisa saja terjadi, jadi jika kamu memiliki tambahan atau koreksi, mari kita diskusikan di kolom komentar untuk memperkuat pemahaman kita bersama. Semoga membantu 👋.